Tác giả bài gốc: Lance Martin (Member of Technical Staff). Đăng ngày 28/09/2026 trên claude.dev.
Các bài đánh giá (eval) cho bạn tín hiệu về mức độ hiệu quả của ứng dụng hoặc skill trên những tác vụ cụ thể. Nhưng thiết kế eval và cải thiện kết quả trên đó mà không tự đánh lừa mình là việc khó. Chúng tôi đã thêm hướng dẫn cho cả hai việc này vào skill claude-api.
Với skill này, bạn có thể chạy /claude-api build-eval để xây dựng một eval ngay trong codebase, rồi chạy /claude-api hillclimb để cải thiện ứng dụng theo eval đó, mỗi lần một thay đổi, với một tập ví dụ được giữ riêng để phát hiện hiện tượng quá khớp (overfitting).
Trong bài viết này, trước tiên chúng tôi nêu những nguyên tắc thiết kế eval tốt và tối ưu từng bước (hillclimbing), rồi cho thấy Claude Code cùng skill claude-api áp dụng những nguyên tắc đó như thế nào. Cuối bài, chúng tôi sẽ đưa ra một vài ví dụ về các lệnh này.
Thiết kế eval
Các eval được thiết kế tốt có một vài yếu tố chung (Hình 1):
- Tác vụ eval phản ánh production. Lấy mẫu những tác vụ bạn quan tâm trong “production”, hoặc trong môi trường mà năng lực hay ứng dụng đang được kiểm thử sẽ được sử dụng. Đôi khi người ta chọn tác vụ vì chúng dễ tạo hoặc dễ chấm điểm. Nhưng điều quan trọng là đảm bảo phân bố tác vụ đại diện cho những gì bạn thực sự quan tâm.
- Kết quả cải thiện khi dùng model mạnh hơn và suy nghĩ nhiều hơn. Model có năng lực cao hơn và mức effort cao hơn thường phải cho kết quả tốt hơn trên eval. Nếu không, nguyên nhân thường là tác vụ mơ hồ hoặc bộ chấm điểm (grader) được hiệu chỉnh chưa đúng đang làm giảm kết quả.
- Ngay cả ở mức năng lực cao nhất, vẫn còn dư địa cải thiện có thể đạt được. Model mạnh nhất ở mức effort cao nhất phải có điểm thấp hơn đáng kể so với 100% trên eval; nếu không, bạn không thể đánh giá đáng tin cậy tác động của các thay đổi đến kết quả. Điều quan trọng là khoảng cách đó không được bắt nguồn từ những tác vụ bất khả thi hoặc mơ hồ: một dấu hiệu thường gặp là tác vụ thất bại trong mọi lần chạy eval, bất kể số lần lặp. Tác vụ tốt là tác vụ mà hai chuyên gia trong lĩnh vực sẽ đưa ra cùng một kết luận và mọi thứ grader kiểm tra đều được nêu trong tác vụ.
- Phương sai giữa các lần chạy thấp. Phương sai cao thường do tác vụ được thiết kế kém, mơ hồ, hoặc grader đưa ra kết luận khác nhau với cùng một output. Phương sai cũng có thể ẩn trong cấu hình. Chẳng hạn, effort có thể không được áp dụng nhất quán. Môi trường cũng có thể ảnh hưởng đến kết quả eval: trạng thái còn sót lại từ lần thử trước (một file, lịch sử git) có thể đưa sẵn đáp án cho agent.
Hình: Điểm số theo số token hành động trong mỗi lần thử, cho một model nhỏ hơn, một model cỡ trung và model mạnh nhất ở mức effort thấp, trung bình và cao. Các chú thích đánh số đánh dấu bốn yếu tố: điểm tăng khi model mạnh hơn và effort cao hơn, đường trên cùng vẫn thấp hơn điểm tuyệt đối, và các thanh sai số vẫn hẹp.
Bốn yếu tố của một eval tốt
Lấy mẫu đối kháng
Năng lực model không đồng đều. Nếu bạn chọn trường hợp chỉ vì model hiện tại thất bại ở đó, bạn đang lấy mẫu tại những vùng trũng trên bề mặt năng lực của một model (Hình 2). Eval có thể cuối cùng đo dấu vết thất bại riêng của model đó, thay vì đo những gì vốn khó hoặc có giá trị đối với ứng dụng của bạn.
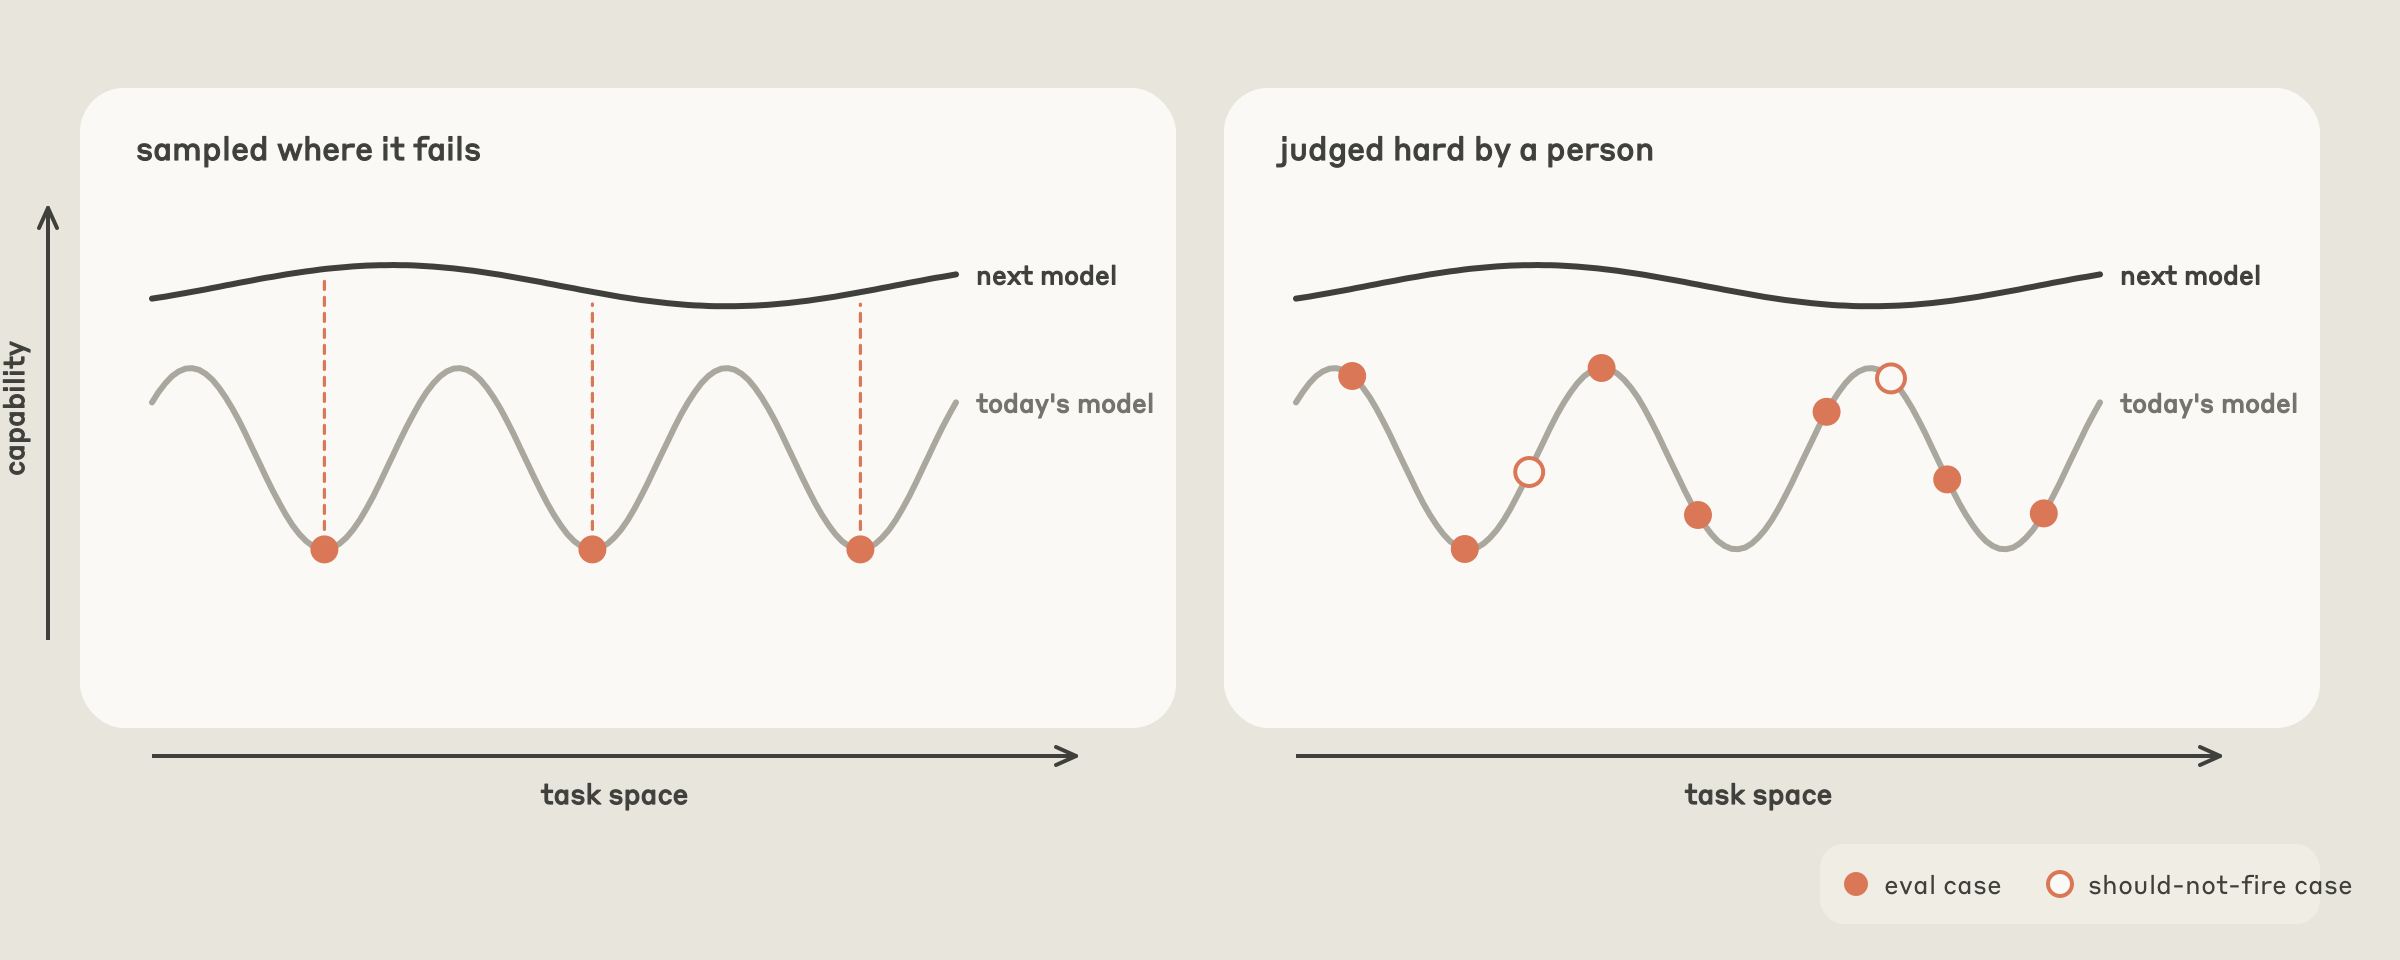
Lấy mẫu đối kháng
Chọn các trường hợp khó vì con người đánh giá chúng khó: một cách kiểm tra hữu ích là bạn phải nói được vì sao tác vụ khó trước khi đưa nó vào eval. Hãy đưa vào những trường hợp thất bại cụ thể trong ứng dụng, lấy từ lưu lượng production, báo cáo lỗi hoặc ticket. Tuy nhiên, đừng tin mù quáng vào lưu lượng người dùng: đôi khi người dùng chỉ thử những việc họ kỳ vọng sẽ thành công, nên phân bố tác vụ lấy hoàn toàn từ lưu lượng người dùng có thể nghiêng về những trường hợp dễ.
/claude-api build-eval
Lệnh build-eval trong skill claude-api biến những nguyên tắc này thành một workflow có hướng dẫn. Khi bạn chạy /claude-api build-eval trong Claude Code, Claude hỏi bạn để thu thập thông tin, xây dựng eval trong codebase và dừng tại những điểm cụ thể để chờ bạn phê duyệt.
Thiết kế ví dụ
Claude giúp bạn lấy mẫu input để xây dựng eval theo thứ tự sau:
- Bản ghi từ production, sau khi hỏi về việc lưu giữ và dữ liệu nhạy cảm.
- Báo cáo lỗi và ticket hỗ trợ.
- Năm đến mười trường hợp bạn tự viết.
- Các trường hợp được tổng hợp từ codebase của bạn.
Skill ưu tiên lưu lượng production, nhưng cũng có thể tạo dữ liệu tổng hợp dựa trên một vài ví dụ thực tế mà bạn cung cấp. Skill hướng dẫn Claude tạo một trang đơn giản hiển thị mọi input và chờ đến khi bạn xác nhận chúng. Để minh họa, bên dưới chúng tôi đưa ra một tập input ví dụ cho ứng dụng định tuyến e-mail mà skill có thể yêu cầu người dùng xem xét (Hình 3).
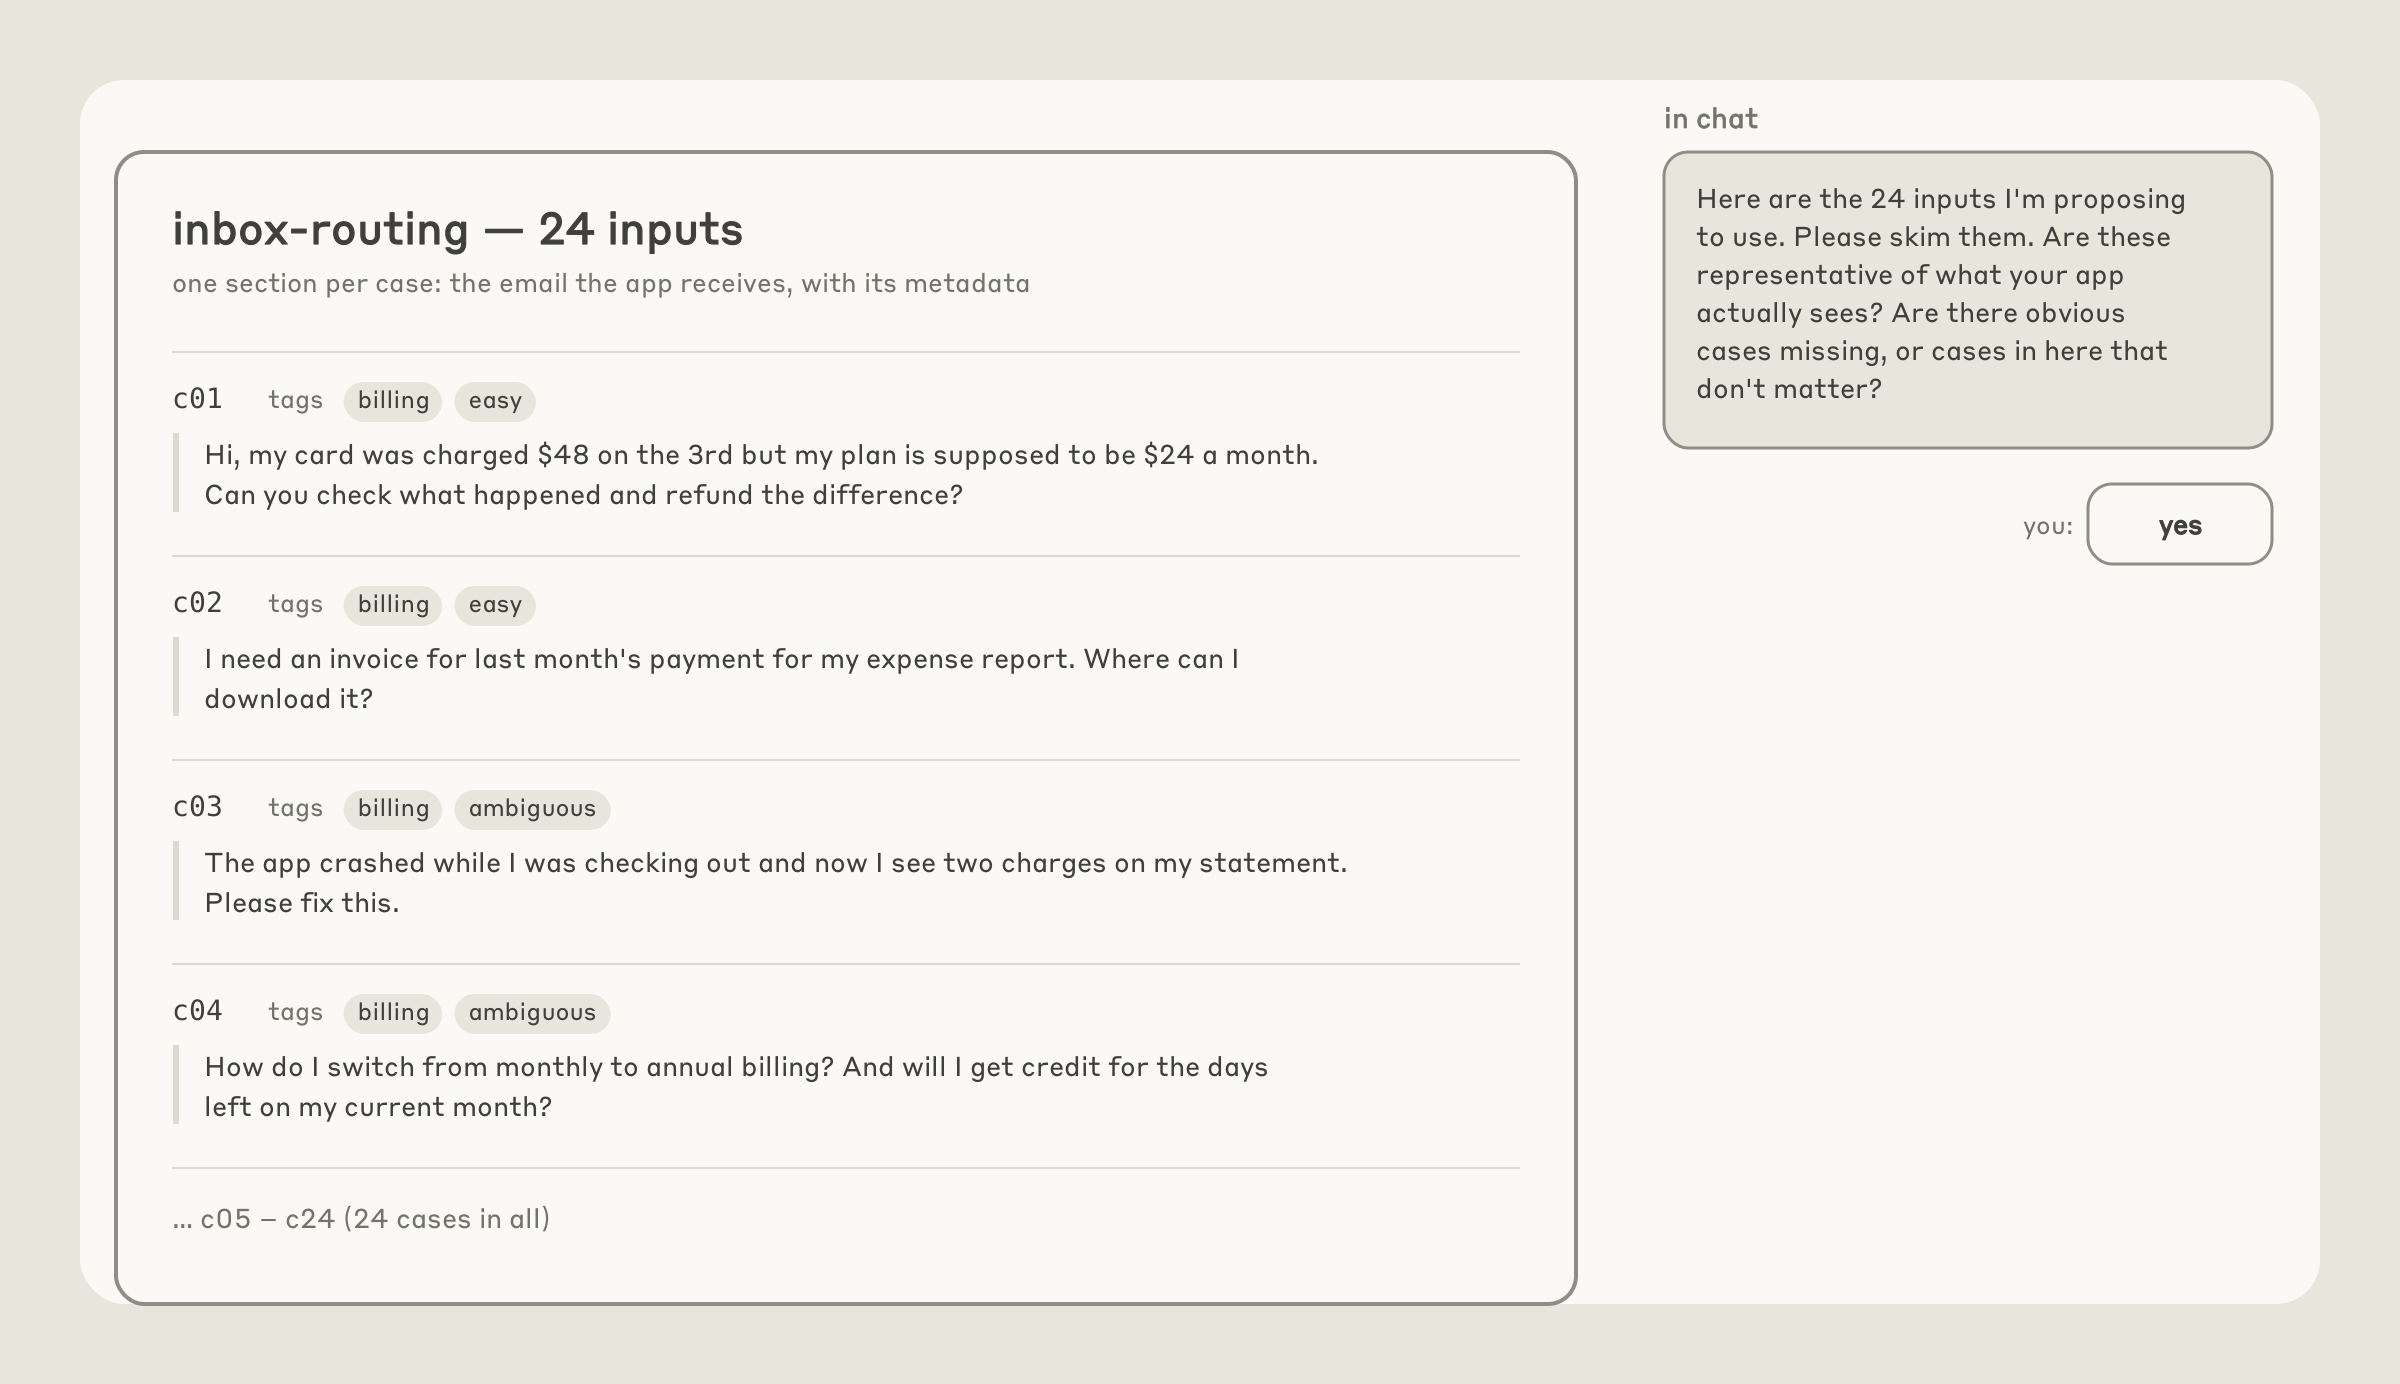
Trang xem xét input ví dụ do skill tạo
Kiểm chứng grader
Sau phần input, Claude đề xuất grader có chi phí thấp nhất phù hợp với output của ứng dụng:
- Kiểm chứng bằng chương trình: Nếu các output có thể có bị giới hạn, nó dùng kiểm tra bằng code (khớp chính xác, nhãn thuộc một tập cố định, JSON khớp schema, các test chạy thành công).
- Dùng LLM làm người chấm (LLM-as-judge): Nó mặc định dùng cách kiểm tra này nếu không gian output mở, với nhiều câu trả lời hợp lệ nhưng tiêu chí chất lượng rõ ràng. Trong trường hợp này, một model thứ hai đọc input, output và bảng tiêu chí được viết thành những mệnh đề có thể kiểm tra (không phải thang điểm 1 đến 5), rồi trả về điểm số cùng lập luận. Nếu bạn có một phương án gốc (baseline) để so sánh, thay vào đó model chấm sẽ đọc cả hai input theo thứ tự ngẫu nhiên, không được cho biết đâu là baseline, rồi chọn phương án tốt hơn. Bạn chọn model chấm, và nó không nên là model đang được kiểm thử.
Claude chấm một vài trường hợp rồi hỏi liệu bạn có chấm khác ở trường hợp nào không (Hình 4). Nhìn chung, điều quan trọng là đọc một mẫu các bản ghi đã được chấm điểm trước khi tin vào bộ đánh giá; lỗi chấm điểm là một trong những nguyên nhân phổ biến nhất khiến eval bị cấu hình sai.
Khi bạn đã kiểm chứng grader, skill cho biết quy mô tập eval (số trường hợp × số lần lặp × model, cùng thời gian ước tính), chạy baseline và in điểm số kèm khoảng tin cậy. Những gì bạn nhận được gồm: các trường hợp, grader, runner, một dòng JSON và một bản ghi đầy đủ cho mỗi trường hợp, cùng một trang đơn giản liệt kê điểm của từng trường hợp với đường dẫn đến bản ghi. Nếu muốn nhiều hơn những gì trang đó hiển thị (chẳng hạn biểu đồ), bạn chỉ cần yêu cầu, Claude sẽ xây dựng một trang bổ sung bên cạnh. Mặc định, những trang bổ sung này là file tĩnh mở cục bộ và không tải gì từ mạng.
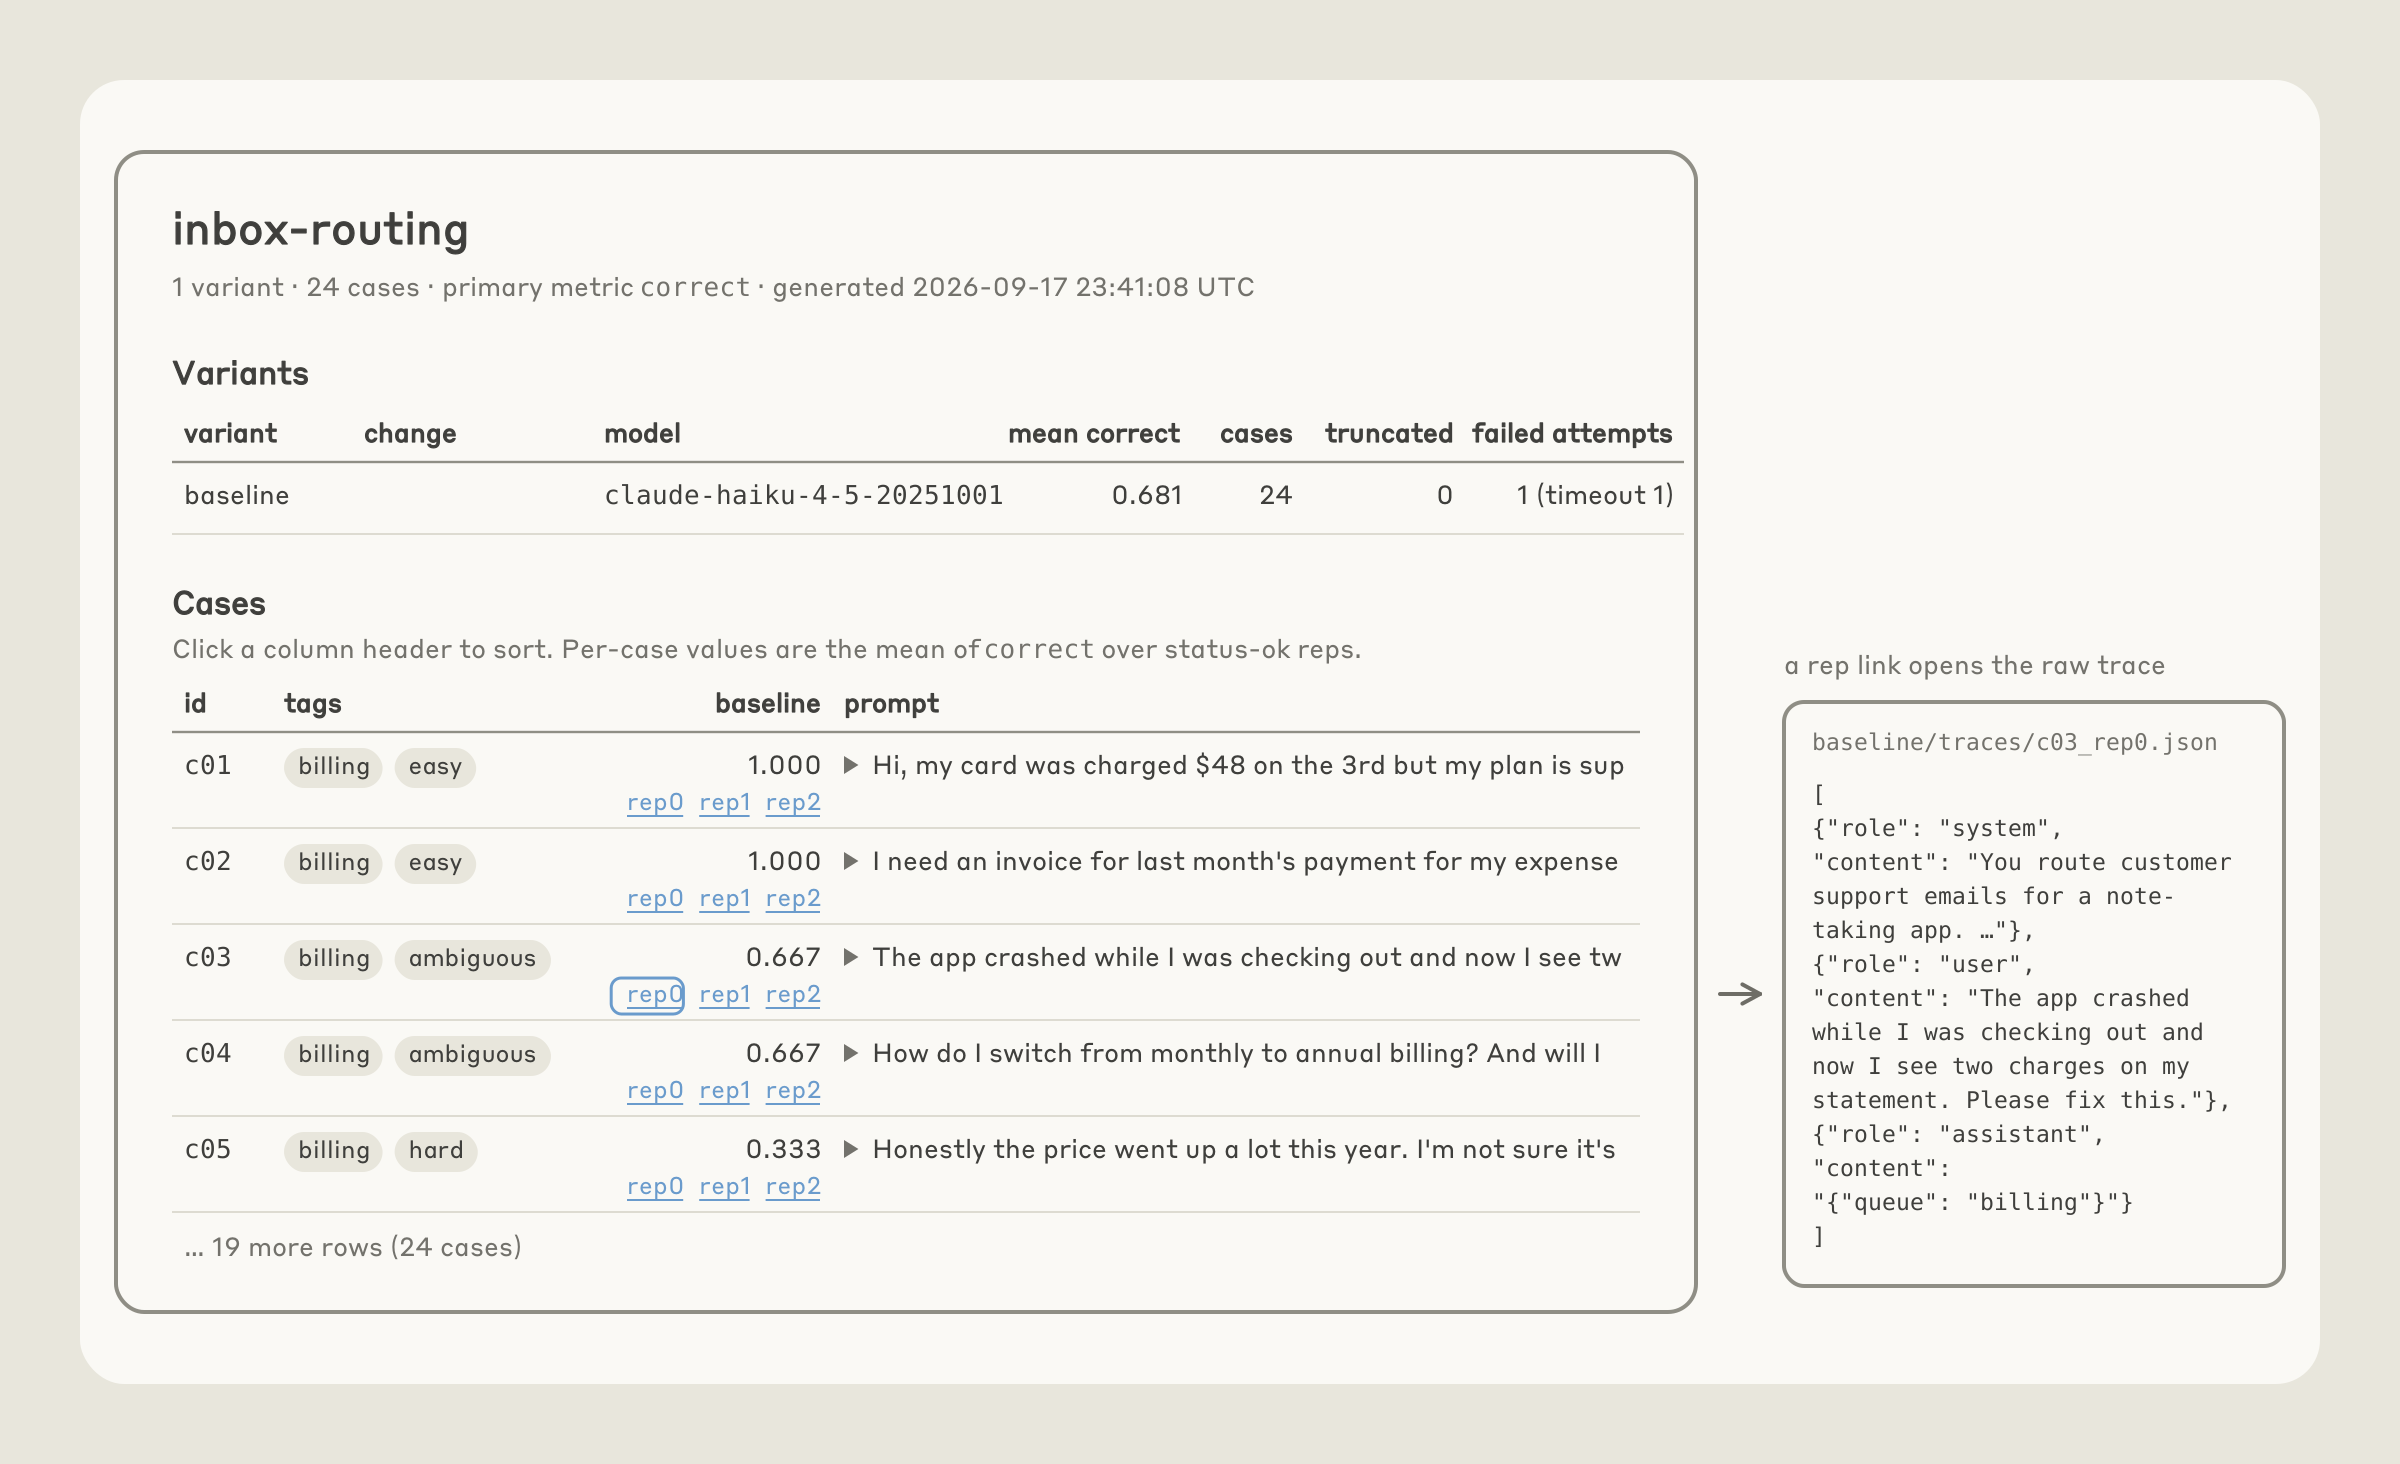
Sơ đồ minh họa trang kết quả được tạo với điểm đề xuất cho từng input.
Các bước kiểm tra chẩn đoán
Trong những lần chạy baseline đề cập ở trên, Claude kiểm tra một số điều:
- Grader: Claude chạy grader hai lần trên cùng một output và báo cáo liệu kết luận có thay đổi hay không.
- Hạ tầng vận hành: Claude kiểm tra timeout, lỗi API và câu trả lời bị cắt cụt để đảm bảo nhiễu từ hạ tầng không bị nhầm thành phương sai của model.
- Dư địa cải thiện: nếu baseline đã đạt khoảng 95% trở lên, skill cảnh báo người dùng rằng hillclimb nên tập trung tìm cách cải thiện chi phí hoặc latency thay vì chất lượng.
Hillclimbing
Giờ bạn đã có một cách đáng tin cậy để chấm kết quả ứng dụng trên một tác vụ, bạn có thể thử cải thiện nó. Hillclimbing là một cách hiệu quả để điều chỉnh các tham số như effort hoặc prompt, vốn tạo ra sự đánh đổi giữa chi phí và kết quả. Một vài gợi ý chung để chọn nơi áp dụng:
- Chi phí lặp thấp - Việc sửa đổi thành phần mà bạn tập trung tối ưu bằng hillclimbing phải ít tốn kém (về thời gian, chi phí và công sức). Nhiều dự án nội bộ và khách hàng tập trung hillclimbing vào văn bản, như prompt và skill. Chúng dễ thay đổi và hoàn tác. Ngược lại, việc sửa đổi harness của agent theo hướng mở trong quá trình hillclimbing có thể đòi hỏi thay đổi code trên diện rộng.
- Quy được nguyên nhân - Thay đổi điểm số trên eval phải có thể quy về thành phần mà bạn đang sửa trong quá trình hillclimbing. Chẳng hạn, một số ứng dụng hillclimbing thành công tập trung vào việc kích hoạt skill. Chỉ số đánh giá (tỷ lệ kích hoạt skill) gắn trực tiếp với phần mô tả skill đang được sửa.
- Mục tiêu có phạm vi rõ ràng - Một kiểu thất bại phổ biến là yêu cầu cải thiện kết quả một cách quá mở mà không cân nhắc kỹ dư địa còn lại trong eval; eval gần bão hòa hoặc thành phần cần sửa có phạm vi không rõ (chẳng hạn yêu cầu cập nhật harness một cách mở) dễ bị chững lại hơn. Một mục tiêu thường hiệu quả trong nhiều dự án là chi phí: ngay cả khi eval đã bão hòa, bạn vẫn có thể yêu cầu Claude tìm cách giảm chi phí trong khi giữ nguyên mức kết quả.
Overfitting
Ngay cả eval được thiết kế tốt cũng hiếm khi khớp chính xác với phân bố tác vụ bạn quan tâm trong production. Vì vậy, “overfitting” vào eval là vấn đề thường gặp, dẫn đến một hệ thống đạt kết quả tốt hơn trên eval so với lưu lượng production.
Có nhiều cách để eval “rò rỉ” vào harness của bạn (phần code bao quanh model, gồm prompt, tool và vòng lặp gọi Claude). Chẳng hạn, hãy xét một tác vụ eval được hưởng lợi từ nhận dạng ký tự quang học (OCR), nhưng OCR hiếm khi hữu ích trong các tác vụ production của bạn. Harness chạy eval có thể thêm tool OCR vào ứng dụng, giúp cải thiện benchmark mà không tác động gì đến production. Rộng hơn, hillclimbing có thể thêm vào harness những tính năng xử lý các trường hợp biên trong chính những ví dụ eval bạn đã chọn. Những phần bổ sung này cải thiện điểm eval nhưng không chuyển thành cải thiện trong production (Hình 5).
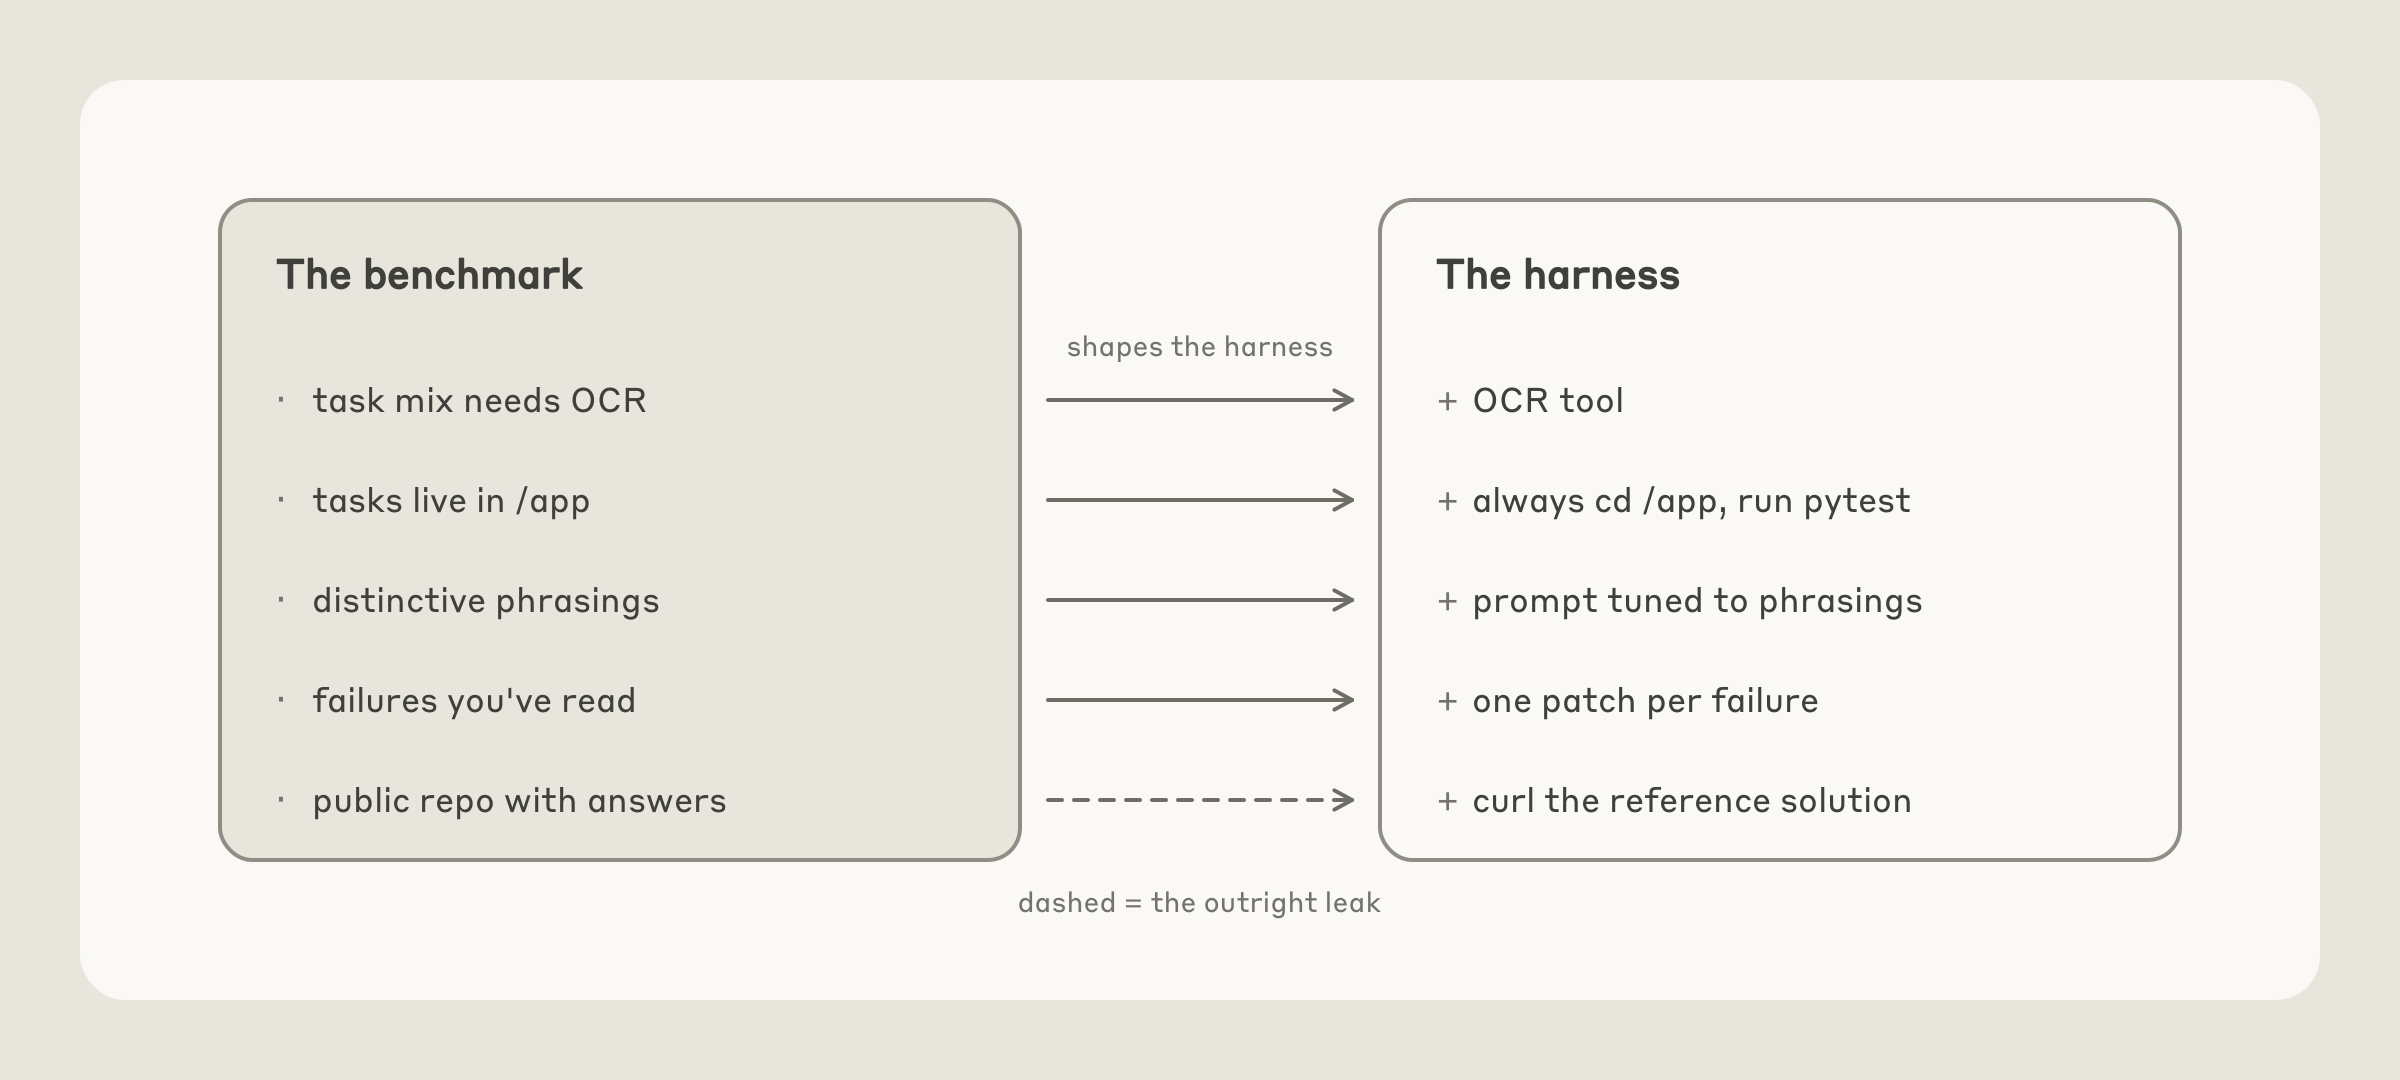
Các nguyên nhân phổ biến gây overfitting ở harness.
Ba việc có thể giúp giải quyết vấn đề này:
- Chia các trường hợp thành tập riêng. Dùng một tập train mà bộ tối ưu hillclimbing có thể đọc và một tập test không bao giờ được xem. Nếu điểm tập train tăng trong khi điểm tập test không đổi, đó là một dấu hiệu cảnh báo overfitting thường gặp.
- Không bao giờ dán nội dung thất bại vào prompt. Nếu bộ tối ưu hillclimbing đọc các bản ghi thất bại, nó không bao giờ được dán nội dung thất bại vào prompt.
- Thiết kế cấu trúc để đáp án nằm ngoài tầm truy cập của model. Đôi khi model có thể “lách phần thưởng” (reward hacking) bằng cách tìm trực tiếp đáp án của eval.
Như phần dưới sẽ trình bày, skill claude-api áp dụng những nguyên tắc này giúp bạn.
/claude-api hillclimb
Lệnh hillclimb trong skill claude-api biến những nguyên tắc này thành một workflow có hướng dẫn. Khi bạn chạy /claude-api hillclimb trong Claude Code, Claude lặp để cải thiện theo một eval đã cho. Bạn chọn những gì nó có thể thay đổi, bao gồm:
- System prompt của bạn
- Skill hoặc file hướng dẫn
- Mô tả tool
- Lựa chọn model, mức effort và các tham số API khác
- Code harness của bạn
Trước khi bắt đầu, Claude hỏi bạn muốn tối ưu điều gì (chẳng hạn kết quả, hoặc chi phí trong khi giữ nguyên kết quả), rồi chia ngẫu nhiên tập eval thành test và train. Với mục tiêu chi phí, nó cân nhắc một vài yếu tố thường làm tăng chi phí, gồm prompt caching, rà soát tính tương thích của prompt với model đã chọn, và lựa chọn model cùng mức effort.
Trước vòng đầu tiên, Claude kiểm tra xem nhiễu của eval (mức điểm số có thể dịch chuyển chỉ do ngẫu nhiên) có nhỏ hơn mức cải thiện tối thiểu đủ để bạn quyết định hành động hay không; nếu không, nó nói rõ và đề xuất tăng số lần lặp hoặc số trường hợp.
Ở mỗi vòng, Claude đọc các bản ghi train của vòng trước và đề xuất một thay đổi dưới dạng bản vá. Mỗi vòng nhắm đến một thay đổi có tác động đủ lớn để vượt lên trên nhiễu của eval: nó sửa hành vi thất bại từ gốc (chẳng hạn viết lại phần gây lỗi hoặc thêm quy tắc còn thiếu), thay vì chỉ diễn đạt lại một dòng. Sau đó, nó chạy eval với thay đổi đã vá. Đến đây, Claude thực hiện một bước kiểm tra: nếu tập train cải thiện nhưng tập test không đổi, Claude nghi ngờ overfitting và hoàn tác bản vá. Nếu kết quả suy giảm, Claude hoàn tác. Nếu cả tập train lẫn test đều cải thiện, nó giữ bản vá (Hình 6).
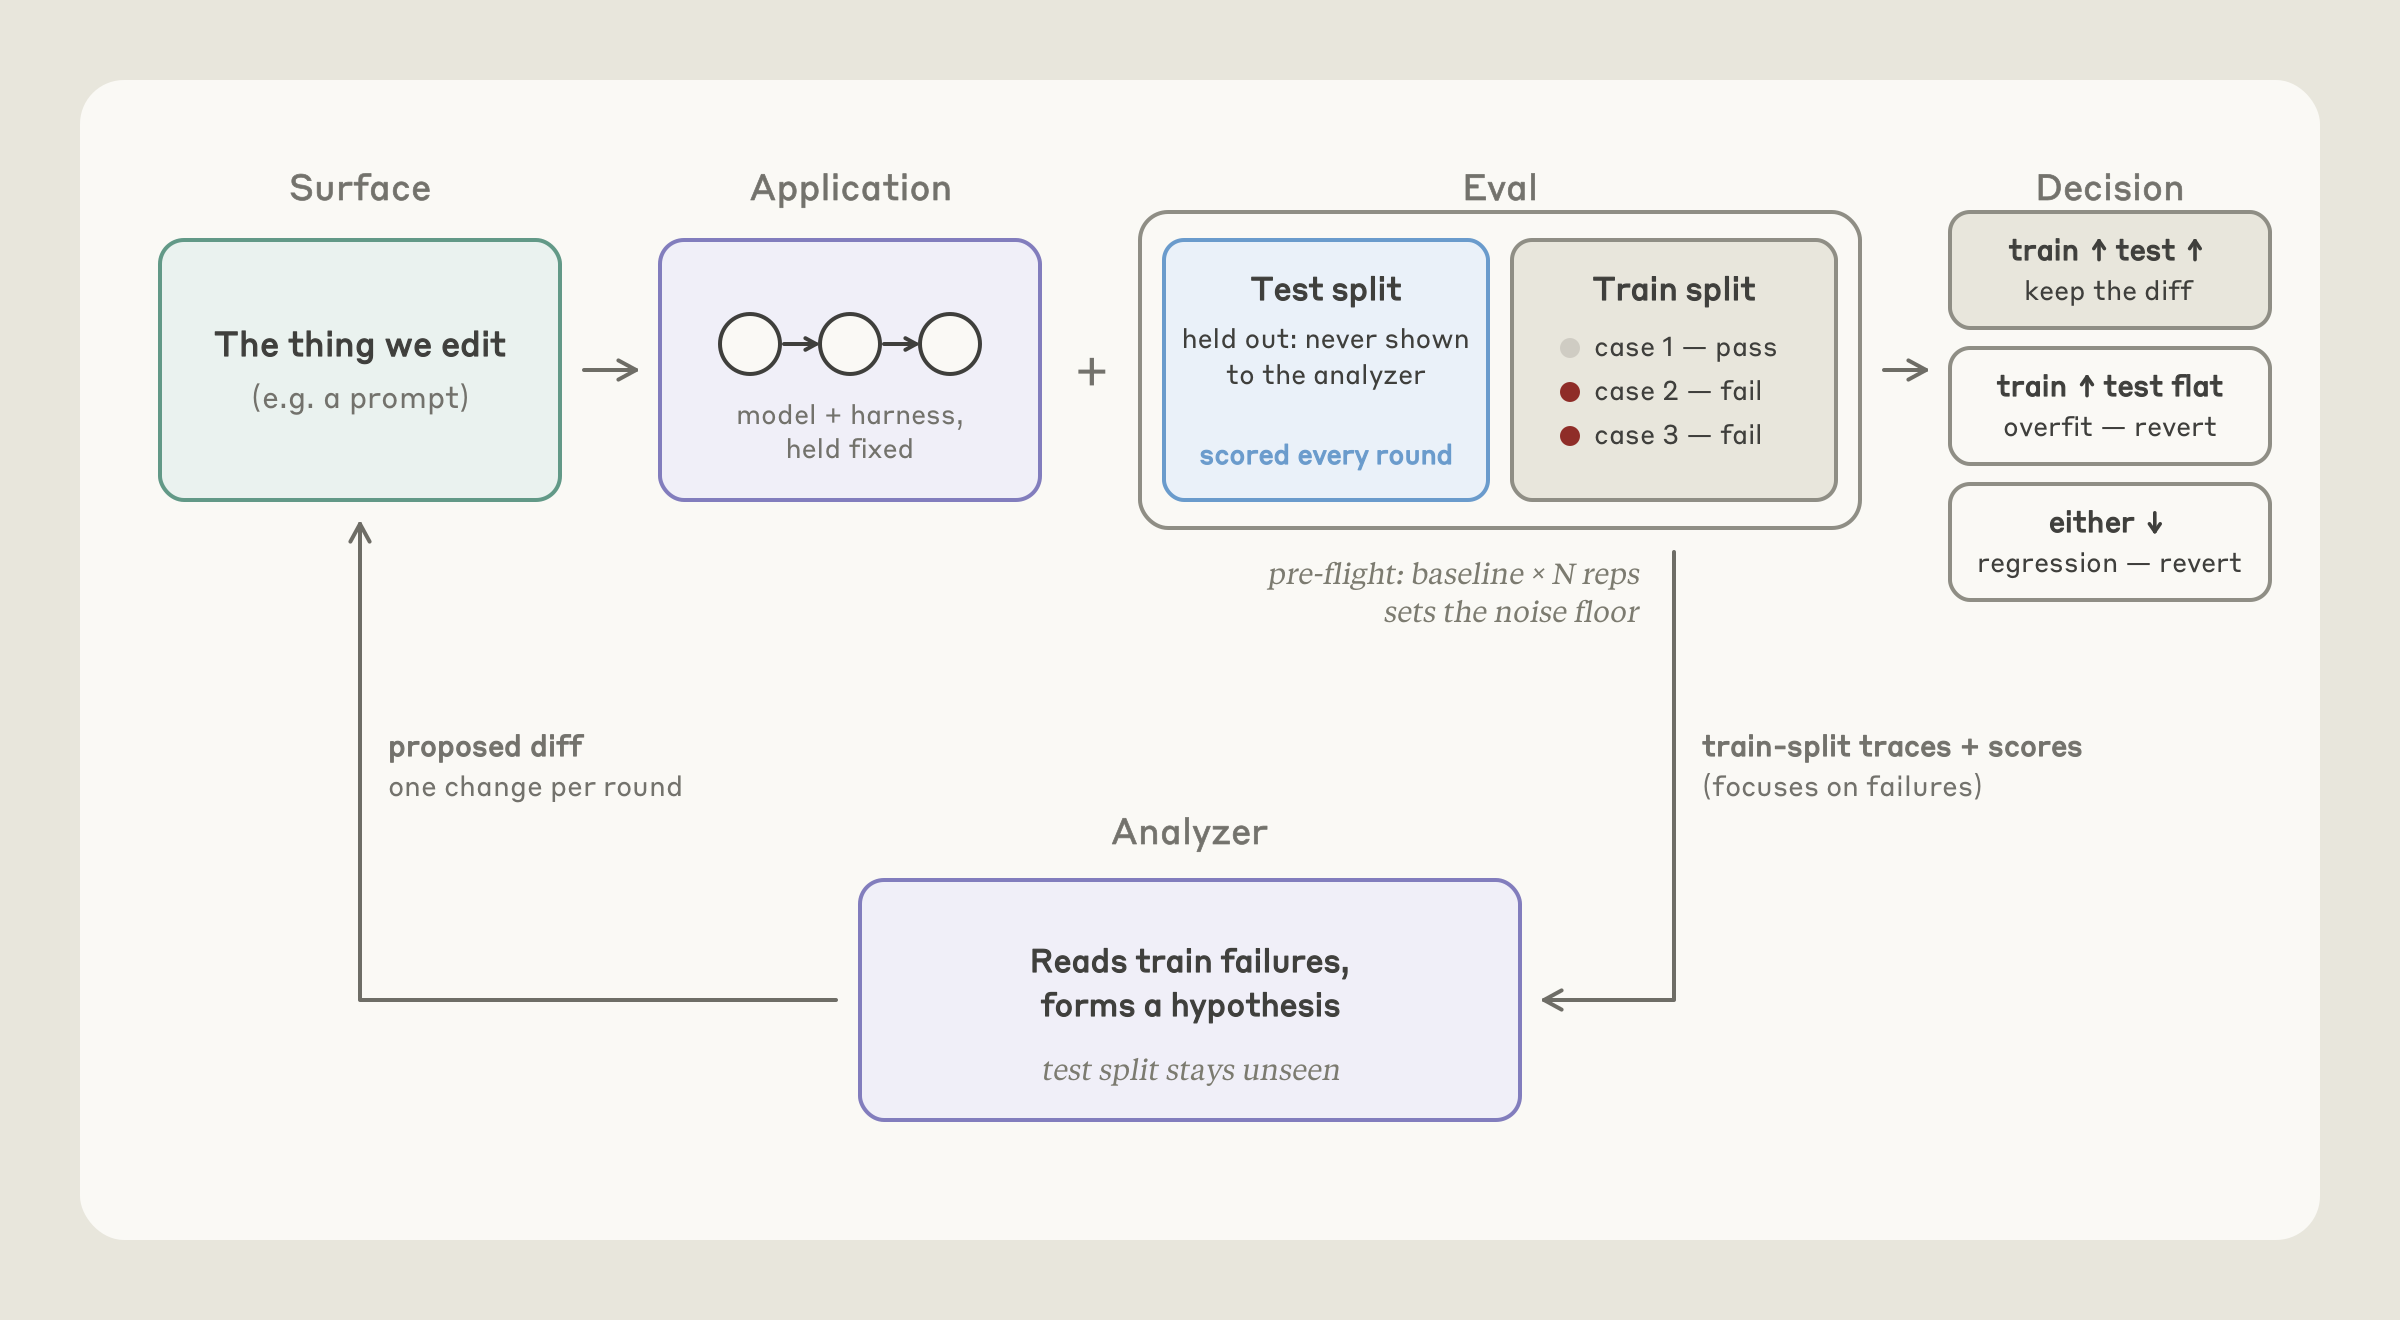
Quy trình mà bộ tối ưu hillclimbing sử dụng.
Khi điểm chững lại trong hai hoặc ba vòng, Claude đọc từng thất bại còn lại ở tập train và phân loại theo nguyên nhân. Nó cũng thực hiện bước này sớm nếu không có một thay đổi đơn lẻ nào đem lại mức tăng lớn hơn nhiễu của eval, rồi đề xuất thêm số lần lặp hoặc số trường hợp thay vì tiêu tốn các vòng vào những thay đổi quá nhỏ để đo được. Bước này có thể phát hiện trường hợp eval mơ hồ, lỗi harness hoặc phương sai giữa các lần chạy.
Chỉ những thất bại thực sự mới được đưa vào các vòng hillclimbing tiếp theo.
Khi hillclimbing hoàn tất, Claude để code của bạn ở phiên bản đạt kết quả tốt nhất trên tập test theo mục tiêu đã chọn. Nó báo cáo kết quả test so với baseline cùng các khoảng tin cậy (Hình 7). Nếu mức cải thiện nằm trong nhiễu, nó nói rõ và khuyên không nên merge.
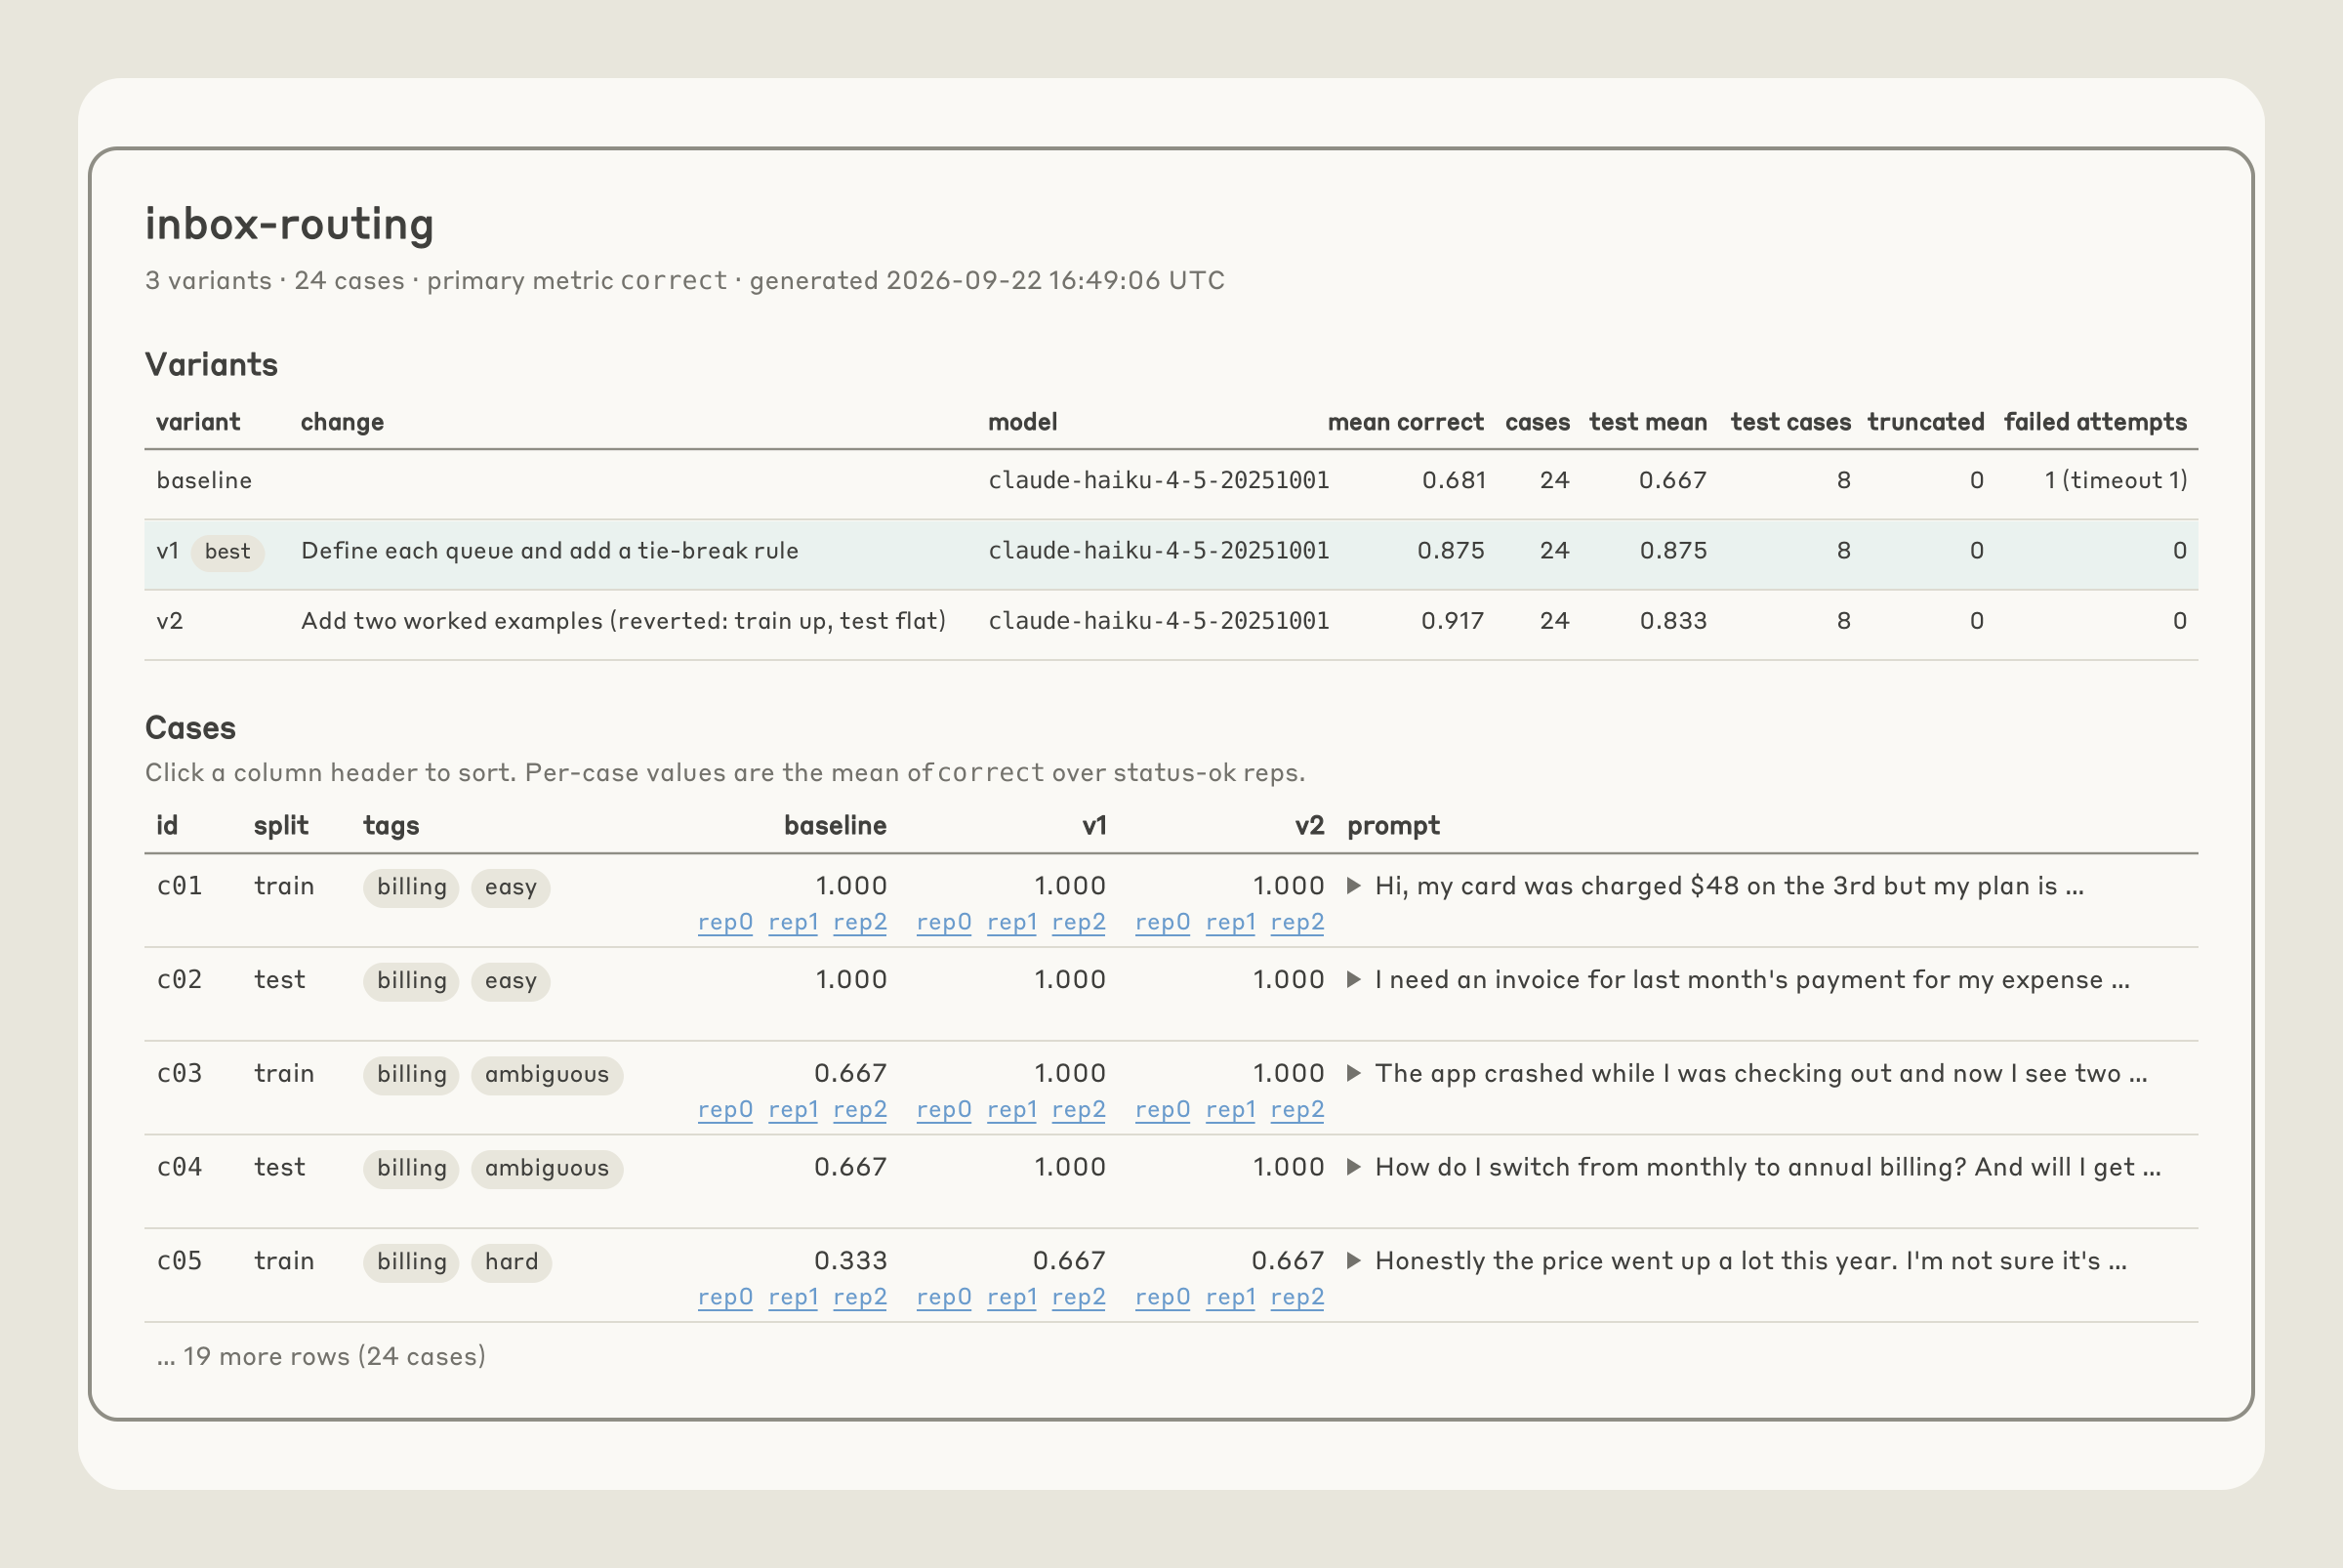
Sơ đồ minh họa báo cáo được tạo sau hillclimbing.
Ví dụ
Hillclimbing để giảm chi phí
Chúng tôi chạy /claude-api hillclimb trên một benchmark hỗ trợ khách hàng nội bộ với mục tiêu giảm chi phí và cải thiện kết quả. Benchmark gồm 44 ticket, trong đó 30 được dùng cho quá trình tìm kiếm cấu hình và 14 được giữ riêng. Điểm xuất phát là Opus 4.8 ở mức effort mặc định (high), với độ chính xác quyết định 74.4% trên các ticket dùng để tìm kiếm và chi phí token 4.6 cent mỗi ticket.
Đầu tiên, quá trình hillclimb rà soát prompt, loại bỏ những thủ tục gọi tool bắt buộc, một bước dùng vùng nháp (scratchpad) và các quy tắc mâu thuẫn. Sau đó, nó thử Opus 5.5 ở mức effort low. Cấu hình này vượt ngưỡng độ chính xác của baseline, đạt 87.8%, đồng thời giảm chi phí xuống 1.9 cent mỗi ticket, chưa bằng một nửa chi phí ban đầu.
Một phần khoản tiết kiệm đó đến từ mức giá của Opus 5.5: token input và output rẻ hơn 20% so với Opus 4.8, còn đọc cache rẻ hơn 60%. Vì Opus 5.5 đã vượt ngưỡng, quá trình hillclimb tiếp tục hạ xuống một bậc để kiểm tra xem model rẻ hơn có thể vượt ngưỡng đó không. Sonnet 5 ở mức effort low đạt điểm gần tương đương, 88.9%, với chi phí khoảng một nửa, 1 cent mỗi ticket (Hình 8).
Hình: Độ chính xác quyết định trên các ticket dùng để tìm kiếm theo chi phí mỗi ticket trên thang logarit, thể hiện lộ trình được chọn: baseline Opus 4.8 với effort high đạt 74.4% và 4.6¢; Opus 5.5 với effort low cùng prompt đã rà soát đạt 87.8% và 1.9¢; Sonnet 5 với effort low cùng prompt đó đạt 88.9% và khoảng 1¢; Sonnet 5 với prompt được cải thiện đạt 98.9% và khoảng 1¢. Đường nét đứt đánh dấu độ chính xác ban đầu 74.4%.
Hillclimbing tập trung vào chi phí.
Cuối cùng, Claude cải thiện prompt bằng các quy tắc định tuyến và một tham chiếu chéo đến hạn mức hoàn tiền, đưa Sonnet 5 lên 98.9% với chi phí gần như không đổi. Trên 14 ticket giữ riêng mà quá trình tìm kiếm chưa từng xem, cấu hình cuối đạt 90.5% so với 78.6% của cấu hình ban đầu, với chi phí chỉ khoảng một phần năm.
Hillclimbing để cải thiện kết quả
Một ví dụ khác là skill claude-api của chúng tôi, cung cấp hướng dẫn dùng các API của chúng tôi và những gợi ý chung khi làm việc với Claude (bao gồm các lệnh con được đề cập trong bài này). Chúng tôi muốn đảm bảo skill có thể triển khai đúng code dùng các API của chúng tôi, nên đã xây dựng một tập eval dựa trên tài liệu để kiểm thử skill.
Trên eval của chúng tôi, skill bắt đầu ở mức 66%. Chúng tôi cho bộ tối ưu hillclimbing truy cập tài liệu và các SDK, để Claude có thể nhận diện lỗi và tự sửa chúng (Hình 9). Claude phát hiện skill thiếu nội dung về tám tính năng.
Thêm các mục tương ứng vào skill giúp nâng kết quả lên 74%. Sau đó, nó phát hiện lỗi trong các bảng kiểu dữ liệu C# và Java, đưa kết quả lên 77%.
Hình: Tỷ lệ đạt qua các vòng hillclimbing trên eval của skill claude-api, tăng từ 66.1% ở baseline lên 87.9% tại vòng 24. Ba giai đoạn đánh số thể hiện công việc: thêm các mục và bảng kiểu dữ liệu còn thiếu, rồi sửa cách skill hướng dẫn Claude viết code, cuối cùng sửa grader cùng những chỉnh sửa bổ sung cho skill.
Hillclimbing tập trung vào kết quả.
Sau khi điểm chững lại trong hai vòng, Claude phân tích những thất bại còn lại và phân nhóm theo nguyên nhân gốc. Một vòng thông thường thực hiện một chỉnh sửa cho lỗi phổ biến nhất. Bước này không chỉnh sửa gì; nó chỉ phân loại mọi thất bại còn lại theo nguyên nhân. Bước nhìn lại này hữu ích ở một vài điểm:
- Khi nhìn lại cả một tập hợp thất bại, bộ tối ưu hillclimbing nhận ra nội dung đã có trong skill nhưng Claude đơn giản là đang viết theo những dạng API cũ (chẳng hạn từ kiến thức có sẵn qua huấn luyện). Để giải quyết, nó thêm một bảng gần đầu skill, hướng dẫn Claude chuyển từ những dạng nó nhớ sang dạng hiện tại: chẳng hạn từ extended thinking với ngân sách token cố định, vốn giờ bị API từ chối trên các model Opus gần đây, sang adaptive thinking; và từ các phiên bản cũ của tool web search và web fetch sang phiên bản hiện tại. Nó cũng chuyển các cảnh báo C# và Java về việc không dùng thinking với ngân sách cố định lên phía trên các ví dụ adaptive thinking tương ứng. Việc này nâng kết quả lên 80%.
- Những tác vụ không bao giờ cải thiện kết quả dù đã khắc phục các thiếu sót nội dung rõ ràng là dấu hiệu cho thấy ví dụ hoặc grader có vấn đề. Một tác vụ yêu cầu code bắt một loại lỗi, trong khi grader lại đòi một chuỗi gồm ít nhất ba loại. Claude diễn đạt lại tác vụ. Hướng dẫn của một grader khác mâu thuẫn với tài liệu của chúng tôi, và kiểm thử API thật cho thấy tài liệu đúng. Khắc phục những vấn đề này, cùng thêm các chỉnh sửa cho skill, đưa kết quả lên ~88%.
Bắt đầu
Lưu ý: Chạy claude update trước. Skill claude-api được tích hợp trong Claude Code, nên cập nhật sẽ giúp bạn có phiên bản mới nhất của các lệnh này.
claude updateSau đó, trong Claude Code:
/claude-api build-eval
/claude-api hillclimb
Bạn có thể dùng trực tiếp các lệnh con này trong Claude Code thông qua skill claude-api:
Chạy /claude-api build-eval nếu bạn muốn tạo một tập eval cho một vấn đề cụ thể. Bạn có thể định hướng nó bằng cách cung cấp quyền truy cập các ví dụ (chẳng hạn trace). Claude sẽ dùng hướng dẫn được chia sẻ trong bài này để thiết kế ví dụ và grader, đồng thời đảm bảo bạn phê duyệt cả ví dụ lẫn grader.
Chạy /claude-api hillclimb nếu bạn đã có eval và muốn Claude cải thiện theo eval đó, dựa trên mục tiêu của bạn (chẳng hạn kết quả tốt hơn, hoặc chi phí thấp hơn trong khi giữ nguyên kết quả). Claude sẽ dùng hướng dẫn được chia sẻ trong bài này để kiểm tra overfitting trong quá trình tối ưu và kiểm tra lỗi trong chính eval, chẳng hạn grader đánh dấu sai một câu trả lời có vẻ đúng hoặc lỗi harness, cả trước vòng đầu tiên lẫn mỗi khi điểm chững lại.
Đặc biệt cảm ơn Misha Khalman vì đã phát triển skill. Cảm ơn Misha Khalman, Michael Segner, Matt Bell, Matt Thanabalan và Punit Shah vì đã review, đóng góp và hỗ trợ sản phẩm.