Tài liệu này trình bày tổng quan các chi tiết kỹ thuật của phần hiện thực fuzzing gốc trong Go, và nhằm làm tài liệu tham khảo cho những người đóng góp.
Kiến trúc tổng quát
Bộ fuzzer dùng một tiến trình điều phối (coordinator) duy nhất để quản lý corpus, và nhiều tiến trình worker để đột biến dữ liệu đầu vào và thực thi fuzz target. Tiến trình coordinator và các tiến trình worker giao tiếp qua một giao thức RPC dựa trên JSON truyền qua pipe, cùng với các vùng bộ nhớ ảo dùng chung.
Với mỗi worker, coordinator tạo một goroutine để sinh ra tiến trình worker và thiết lập kênh giao tiếp liên tiến trình. Mỗi goroutine sau đó đọc từ một channel dùng chung được cấp dữ liệu bởi vòng lặp chính của coordinator, rồi gửi các chỉ thị đọc được từ channel tới tiến trình worker tương ứng.
Vòng lặp chính của coordinator chọn các dữ liệu đầu vào từ corpus và gửi chúng vào channel dùng chung của worker. Worker nào lấy được dữ liệu đầu vào đó từ channel sẽ gửi một yêu cầu fuzzing tới tiến trình worker tương ứng. Tiến trình này nằm trong một vòng lặp, đột biến dữ liệu đầu vào và thực thi fuzz target cho tới khi một lần thực thi làm tăng các bộ đếm coverage, gây panic hoặc crash, hoặc vượt quá thời hạn đã định trước.
Nếu tiến trình worker thực thi một dữ liệu đầu vào đã đột biến làm tăng các bộ đếm coverage hoặc gây một panic có thể phục hồi, nó sẽ báo hiệu điều này cho coordinator, và coordinator khi đó có thể tái dựng lại dữ liệu đầu vào đã đột biến. Coordinator sẽ cố tối giản dữ liệu đầu vào, rồi hoặc thêm nó vào corpus để tiếp tục fuzzing, trong trường hợp tìm thấy coverage tăng thêm, hoặc ghi nó vào thư mục testdata, trong trường hợp dữ liệu đầu vào gây lỗi hoặc panic.
Nếu xảy ra một lỗi không thể phục hồi trong lúc fuzzing khiến tiến trình worker phải tắt (ví dụ vòng lặp vô hạn, os.Exit, cạn kiệt bộ nhớ, v.v.), việc tối giản sẽ không được thực hiện, và dữ liệu đầu vào gây lỗi sẽ được ghi vào thư mục testdata và được báo cáo.
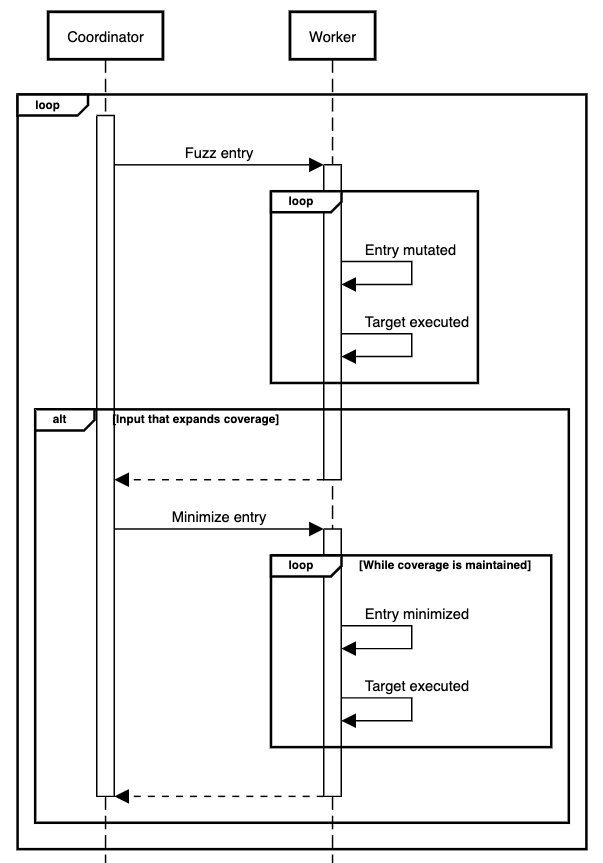
Giao tiếp liên tiến trình
Khi sinh ra các tiến trình worker con, coordinator thiết lập hai phương thức giao tiếp: một pipe, dùng để truyền các thông điệp RPC dựa trên JSON, và một vùng bộ nhớ dùng chung, dùng để truyền dữ liệu đầu vào và trạng thái RNG. Mỗi tiến trình worker có pipe và vùng bộ nhớ dùng chung riêng.
Coordinator dùng pipe RPC để điều khiển tiến trình worker, gửi cho nó các chỉ thị fuzzing hoặc tối giản; còn worker dùng pipe này để chuyển tiếp kết quả các thao tác của nó về cho coordinator (tức là dữ liệu đầu vào có mở rộng coverage không, có gây crash không, có được tối giản thành công không, v.v.).
Vùng bộ nhớ dùng chung được dùng để trao đổi qua lại một số thông tin cụ thể với các worker. Coordinator dùng vùng này để truyền mục corpus cần fuzz cho worker, còn worker dùng nó để lưu trạng thái RNG hiện tại của mình. Trạng thái RNG được coordinator dùng để tái dựng các đột biến mà worker đã áp lên dữ liệu đầu vào khi worker thực thi xong target (việc tái dựng này diễn ra cả khi worker thoát bình thường lẫn khi nó crash.)
Chọn dữ liệu đầu vào
Hiện coordinator chưa hiện thực bất kỳ hình thức ưu tiên dữ liệu đầu vào nâng cao nào. Nó duyệt qua toàn bộ corpus, và lặp lại từ đầu sau khi dùng hết các mục.
Tương tự, coordinator không hiện thực bất kỳ dạng tối giản corpus nào (đừng nhầm với tối giản dữ liệu đầu vào, bàn ở bên dưới).
Dẫn hướng theo coverage
Bộ fuzzer dùng các bộ đếm coverage 8 bit nội tuyến tương thích libFuzzer. Các bộ đếm này được chèn vào lúc biên dịch tại mỗi cạnh của mã, và được tăng khi đi vào. Các bộ đếm không được bảo vệ chống tràn, để chúng không bị bão hoà.
Tương tự AFL và libFuzzer, khi theo dõi coverage, các bộ đếm được lượng tử hoá về luỹ thừa của hai gần nhất. Điều này cho phép bộ fuzzer phân biệt được thay đổi không đáng kể và thay đổi đáng kể trong luồng thực thi. Để theo dõi những thay đổi này, bộ fuzzer giữ một slice byte ánh xạ tới các bộ đếm nội tuyến, mà các bit của nó cho biết có ít nhất một dữ liệu đầu vào trong corpus làm tăng bộ đếm tương ứng ít nhất 2^vị-trí-bit lần hay không. Các byte này có thể bị bão hoà, nếu có những dữ liệu đầu vào khiến các bộ đếm chạm tới mọi giá trị lượng tử hoá, và khi đó bộ đếm tương ứng không còn cung cấp thêm thông tin coverage hữu ích nào nữa.
Vì các bộ đếm coverage được thêm vào mọi cạnh trong lúc biên dịch, mã không được fuzz cũng bị chèn công cụ đo, điều này có thể khiến worker phát hiện coverage mở rộng không liên quan đến target đang được thực thi (chẳng hạn nếu một nhánh mã mới được kích hoạt trong một goroutine không liên quan tới fuzz target). Worker cố giảm bớt điều này theo hai cách: thứ nhất, nó đặt lại toàn bộ bộ đếm ngay trước khi thực thi fuzz target rồi chụp lại các bộ đếm ngay sau khi target trả về; thứ hai, bằng cách bỏ qua một cách tường minh một tập các package có nhiều khả năng gây “nhiễu”
Một số package được chủ ý không chèn bộ đếm, vì chúng dễ tạo ra nhiễu cho bộ đếm mà không liên quan tới target đang được thực thi. Các package đó là:
contextinternal/fuzzreflectruntimesyncsync/atomicsyscalltestingtime
Bộ máy đột biến
Khi worker nhận một dữ liệu đầu vào mới, nó áp các phép đột biến lên dữ liệu đầu vào trước khi thực thi target với dữ liệu đó. Sau mỗi phép đột biến, fuzz target được thực thi với dữ liệu đầu vào mới, và nếu coverage không mở rộng thì các phép đột biến tiếp theo được áp vào. Để tránh việc dữ liệu đầu vào lệch quá xa so với trạng thái ban đầu, sau khi năm phép đột biến được áp lên một dữ liệu đầu vào, nó được đặt lại về trạng thái gốc trước khi áp tiếp các phép đột biến khác. Ví dụ, với dữ liệu đầu vào hello world, chiến lược đột biến có thể trông như sau:
0. hello world [initial state]
1. kello world [replace first byte]
2. world kello [swap two chunks]
3. world ke    [delete last three bytes]
4. owrld ke    [shuffle first three bytes]
5. owrldx ke   [insert random byte]
6. ello world  [reset to initial state, delete first byte]
...
Các bộ đột biến cố thiên về việc tạo ra dữ liệu đầu vào nhỏ hơn thay vì lớn hơn, nhằm ngăn kích thước corpus phình nhanh.
Có rất nhiều bộ đột biến cho kiểu []byte và string, và ít hơn cho tất cả các kiểu int, uint và float.
Hiện chưa có chiến lược đột biến dẫn hướng theo thực thi nào được hiện thực (chẳng hạn input-to-comparison correspondence), cũng chưa có bộ đột biến dựa trên từ điển.
Tối giản dữ liệu đầu vào
Để tránh corpus phình to (điều này làm chậm bộ fuzzer cả về hiệu năng lẫn giảm xác suất một phép đột biến thực sự chạm tới phần dữ liệu thú vị), chúng tôi cố tối giản mỗi dữ liệu đầu vào tìm được mà mở rộng coverage hoặc gây crash có thể phục hồi (những crash không thể phục hồi, chẳng hạn do cạn kiệt bộ nhớ, không được tối giản, vì quá trình đó sẽ cực kỳ chậm). Chiến lược tối giản được dùng khá đơn giản: lần lượt thử bỏ bớt các byte khỏi dữ liệu đầu vào trong khi vẫn giữ được coverage ban đầu đã tìm thấy. Cụ thể, cơ chế tối giản dùng chiến lược sau:
- Thử cắt bỏ một đoạn byte nhỏ dần theo hàm mũ ở cuối dữ liệu đầu vào
- Thử bỏ từng byte riêng lẻ
- Thử bỏ từng tập con byte có thể có
- Thử thay mỗi byte không đọc được bằng mắt thường bằng một byte đọc được (tức là byte nằm trong tập ASCII)